
Tekst- og datautvinning i norsk presse: Religiøse minoriteter i Nasjonalbibliotekets n-gram
Når dukket islam, jødedom og andre minoritetsreligioner opp i norske aviser, og når var omtalen på sitt høyeste? Jeg brukte KI-agenten Claude og Nasjonalbibliotekets fritt tilgjengelige n-gram-datasett med 4,7 millioner avisutgaver for å undersøke dette.
Tekst- og datautvinning og n-gram
Tekst- og datautvinning (TDM, fra engelsk text and data mining) innebærer å bruke digitale verktøy til å søke i, hente ut og analysere ustrukturerte tekstdata (UiO Universitetsbiblioteket). Et n-gram er en sekvens av ett eller flere elementer, vanligvis ord, som blant annet kan brukes til å undersøke utvikling over tid (UiO Universitetsbiblioteket). Nasjonalbiblioteket (NB) har allerede delt opp avistekstene i ord (tokenisering) og telt forekomstene. I dette eksperimentet jobbet jeg derfor med avledede data, uten å utføre tekst- og datautvinningen fra bunnen av.
Det er viktig å følge gjeldende regelverk ved tekst- og datautvinning – mer om dette i det siste avsnittet.
Metode
Jeg lastet ned unigrammene fra avisene i datasettet N-grams from the National Library of Norway 2026, en fil på 14 GB publisert under CC0-lisens. Deretter ga jeg Claude (Claude Team, betalingsversjon), som kjørte i Cowork-modus i skrivebordsappen, tilgang til denne mappen på PC-en min og ba den foreslå analyser innen religionsvitenskap. Av de seks forslagene valgte jeg å undersøke begreper knyttet til religiøst mangfold.
Claude utarbeidet en ordliste med 25 begrepsgrupper, inkludert ulike bøyningsformer og eldre stavemåter. Eksempler er muslim, muhammedaner, jøde, synagoge, buddhisme og sikh. Begrepene ble analysert i Claudes skybaserte arbeidsmiljø. Etter omtrent ni minutter leverte Claude et Python-skript, tre CSV-filer og to diagrammer. Skriptet dokumenterer alle stegene i analysen, slik at den kan etterprøves og kjøres på nytt. Dette er viktig for vitenskapelig etterprøvbarhet og troverdighet.
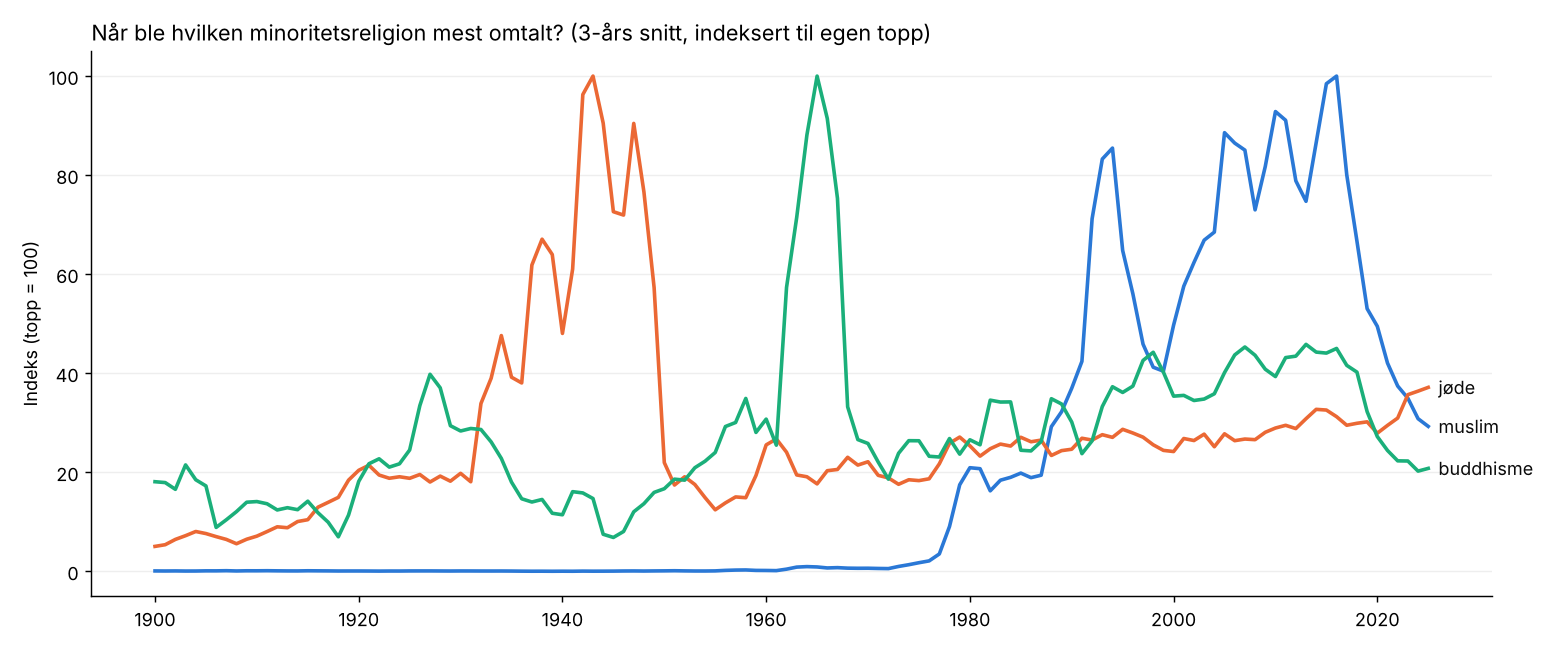
Figur 1. Muslim, jøde og buddhisme, treårig glidende gjennomsnitt, indeksert mot hvert begreps egen toppverdi (= 100). Kilde: NB N-gram 2026, CC0.
Begrepet jøde har en tydelig topp rundt andre verdenskrig. For buddhisme ser vi en markant topp på 1960-tallet. Begrepet muslim ble knapt brukt før 1980-tallet, men har flere topper i de siste tiårene. Dette gjorde meg nysgjerrig på hvilke andre betegnelser for muslimer som ble brukt før 1980-tallet. Jeg ba derfor Claude lage et diagram som undersøkte dette. Se figur 2 nedenfor.
Mange av toppene sammenfaller med kjente historiske hendelser, men n-gram viser bare at et ord er brukt, ikke hvordan eller hvorfor det er brukt. Dette blogginnlegget legger større vekt på metoden enn på funnene, og jeg går derfor ikke nærmere inn på tolkning og diskusjon av resultatene.
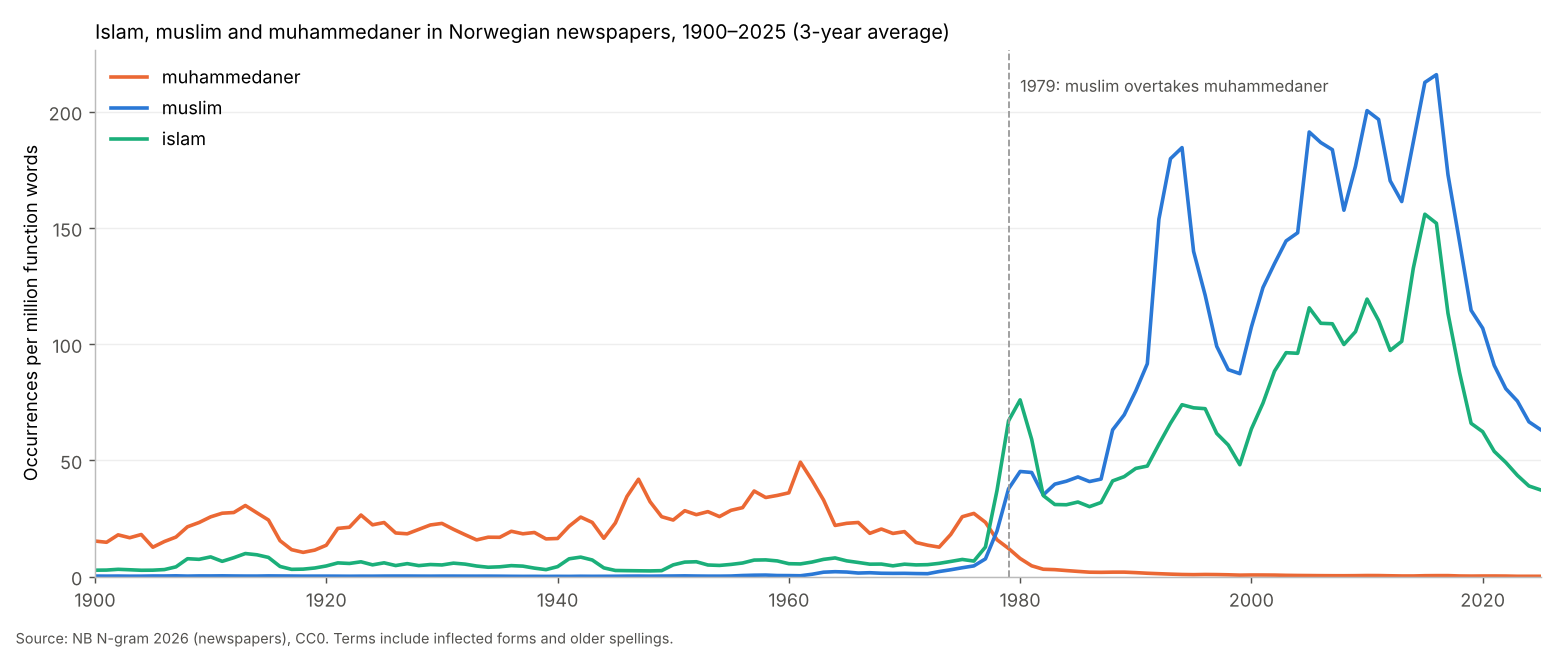
I figur 2 ser vi at begrepene muhammedaner og islam tidligere var mer brukt enn muslim. Dette endret seg da muslim passerte muhammedaner i 1979 og begge begrepene innen 1982. Nedenfor, i figur 3, ser vi resultatene for et utvalg andre begreper knyttet til religiøst mangfold.
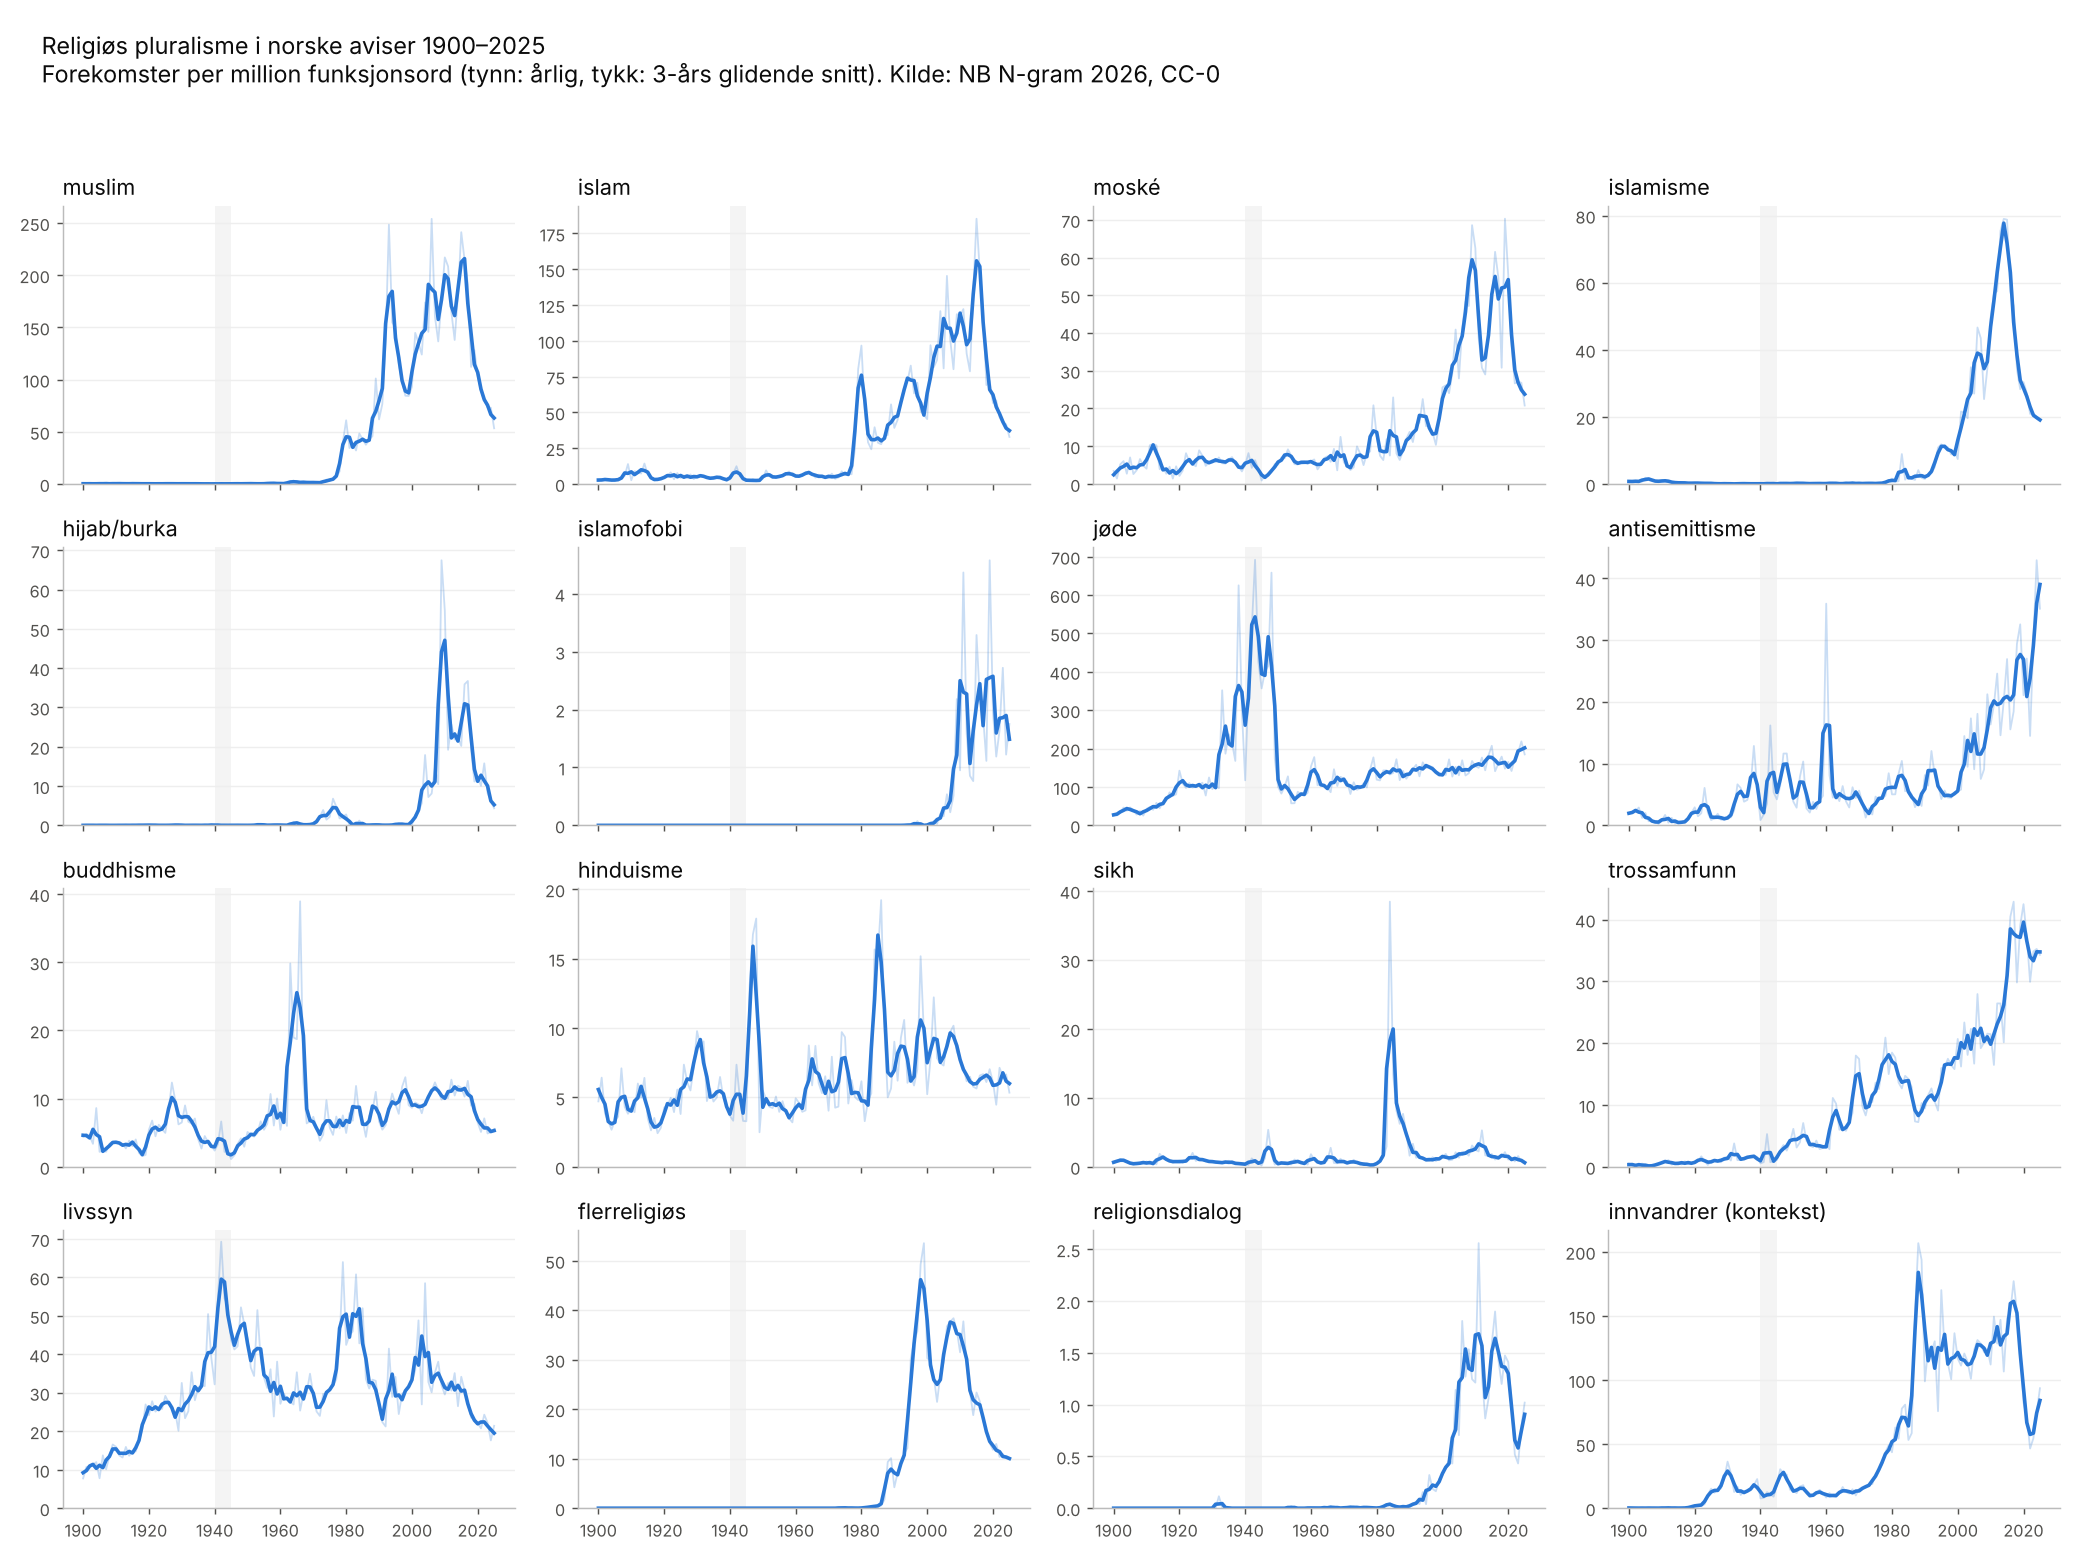
Figur 3. 16 begreper knyttet til religiøst mangfold, forekomster per million funksjonsord. Tynn linje: årlige verdier. Tykk linje: treårig glidende gjennomsnitt. Kilde: NB N-gram 2026, CC0.
Mindre KI
Det er mulig å redusere bruken av KI, eller å klare seg helt uten dersom man behersker programmering. En mellomløsning er å la KI skrive koden, men kjøre den selv i Python og Jupyter. Da forlater ikke dataene din egen datamaskin. Denne metoden bruker også mindre energi.
UiO har laget en oversikt over egnede verktøy for tekst- og datautvinning. DH-laben ved MF kan hjelpe deg både med en KI-basert tilnærming og med en kombinasjon av KI, Python og Jupyter Notebook.
Lovlig tekst- og datautvinning – og mulige lovendringer som kan legge til rette for forskning
At en tekst er teknisk tilgjengelig, betyr ikke nødvendigvis at det er lovlig å utføre tekst- og datautvinning på den. Man kan for eksempel ikke uten tillatelse utføre TDM på artikler fra åpent tilgjengelige nyhetsmedier som NRK, eller på kopier av artikler lagret i Wayback Machine. Norge har foreløpig ikke et tydelig rettslig grunnlag for dette.
Det kan imidlertid endre seg. Prop. 41 LS (2025–2026) foreslår endringer i åndsverkloven, blant annet et generelt unntak for tekst- og datautvinning fra verk man har lovlig tilgang til, og et særskilt unntak for forskning og kulturarvinstitusjoner. Stortingskomiteen avga sin innstilling 10. november 2026, men lovendringene har ennå ikke trådt i kraft.
Les mer om lovligheten av tekst- og datautvinning i denne artikkelen på Forskerforum.no.
I mellomtiden tilbyr Nasjonalbibliotekets n-gram et åpent og lovlig utgangspunkt for omfattende og interessante undersøkelser med tekst- og datautvinning.
Et neste steg kan være å gå videre fra unigrammer til bigrammer og trigrammer for å undersøke hvilke ord som forekommer sammen med muslim, for eksempel norske muslimer, i ulike tidsperioder ved hjelp av Nasjonalbibliotekets n-gram-tjeneste.
Deklarasjon om bruk av KI
Analysen ble gjennomført med Claude (Claude, Team, Anthropic), i Cowork-modus i skrivebordsappen. Claude foreslo analyser, skrev og kjørte koden, produserte diagrammene og utarbeidet et førsteutkast til blogginnlegget basert på mine notater. Jeg bearbeidet deretter teksten betydelig. Forskningsspørsmålet, tolkningen av resultatene og det endelige redaksjonelle ansvaret ligger hos forfatteren.
Toppbilde: KI-generert illustrasjon laget med OpenAIs bildegenereringsverktøy i ChatGPT, 11. november 2026.
Oversettelse til norsk er gjort av ChatGPT med lett bearbeiding.
Flere artikler fra MF L-MaSDR, Forskning, AI, digital humaniora, Digital humanities, Distant reading, KI, TDM, text data mining, tekstutvinning og religious minorities
Bruk av KI-agenter til å utvikle en VRE-prototype for manuskriptstudier
Published: 16. november 2026
This post presents an experiment in AI-assisted digital humanities development. Using Claude Code, I built a local prototype of a Virtual Research Environment (VRE) for the study of Tatian’s Diatessaron. The purpose was to test whether AI-assisted coding can help transform manuscript data, research notes, and a conceptual model into a working tool for visualization, collation, and textual comparison.
Lærer demokrati gjennom erfaring
Published: 19. oktober 2026
Ved MF har lærerstudenter utforsket historie gjennom egne plakater og øvd på krevende klasseromssituasjoner gjennom forumteater. Hva kan slike læringsformer bety for inkludering, demokratiforståelse og lærerrollen? Det er spørsmål Claudia Lenz, Trine Anker og Merethe Skårås har undersøkt gjennom forskning på egen undervisning i MFs lektorprogram.
Tillit i stort og smått
Published: 9. oktober 2026
Hva er det som gjør at mennesker stoler på hverandre, og på institusjonene som omgir dem? Tillit handler om langt mer enn personlige relasjoner. Den formes av rettferdighet, fellesskap og verdiene som binder et samfunn sammen. Les professor Asle Eikrems refleksjoner rundt temaet for årets Verdensdag for psykisk helse.
Tilliten som oppgave
Published: 8. oktober 2026
Tillit er samfunnets viktigste beredskapsressurs. Vi ble født med tillit, og vi lever best dersom vi verner om den gaven tilliten er. Da tar vi også vare på samfunnet vårt. Les professor Jan-Olav Henriksens refleksjoner rundt temaet for årets Verdensdag for psykisk helse.